eps1.5IA
Engenharia de Harness
O que é Engenharia de Harness e como preparar seu repositório para operar com agentes de IA de forma segura, previsível e produtiva.
Você e uma pessoa do seu time usam o mesmo modelo, na mesma ferramenta, no mesmo repositório. Para você o agente acerta de primeira, roda os testes e segue as convenções do projeto. Para a outra pessoa ele inventa comando, ignora o lint e quase apaga uma pasta. O modelo é o mesmo, mas então o que mudou?
Mudou tudo o que está em volta do modelo. E é isso que a gente chama de harness.
Nos posts anteriores falamos de Janela de Contexto, Rules e Skills e Spec-Driven Development. Tudo aquilo é uma parte do harness. Neste post a gente dá um passo atrás para enxergar o quadro inteiro: o que é harness, quais são os mecanismos que o compõem, como medir a maturidade do harness de um repositório e o que fazer para melhorar.
Sumário
- O que significa Harness?
- Agente = Modelo + Harness
- As camadas do harness
- Os três mecanismos: guias, sensores e grades de proteção
- Como o harness roda?
- O que é Engenharia de Harness?
- Harness Score: medindo a maturidade do repositório
- Conclusão
- Referências
O que significa Harness?
Harness vem do inglês e significa arreio: todo o conjunto de peças usado para montar e guiar um cavalo com segurança. Não é só a sela, onde o cavaleiro senta. São as rédeas, as correias, tudo o que dá controle sobre o animal.
A analogia encaixa bem, pois a ideia do harness é controlar para onde a IA vai, limitar o que ela pode fazer e dar guias e sensores para que ela seja mais efetiva.
Agente = Modelo + Harness
Todo mundo fala de agente, mas o que é um agente? A definição mais aceita hoje, popularizada pelo artigo The Anatomy of an Agent Harness da LangChain, é bem direta:
- Modelo: a LLM em si. Opus 5, Sonnet 5, GPT 5.6, Grok 4.7 high, Composer 2.5 etc.
- Harness: todo o resto. System prompts, skills, tools e MCPs (conectores que dão ao agente acesso a sistemas externos, como Jira, Slack ou um banco de dados), infraestrutura (browser, sistema de arquivos etc.), hooks, lógica de orquestração e memória.
O modelo, sozinho, recebe texto e devolve texto. Ele não guarda estado entre uma conversa e outra, não executa código, não acessa a internet e não instala pacote. Tudo isso vem do harness:
- System prompt: toda ferramenta (Cursor, Codex, Claude Code) tem um prompt por trás que é concatenado com a sua pergunta. Só ele já muda o quão assertivo o agente vai ser.
- Skills, tools e MCPs: as habilidades e ferramentas que o agente pode chamar.
- Infraestrutura conectada: acesso ao sistema de arquivos, ao terminal, a um navegador.
- Hooks: eventos disparados antes ou depois de uma ação do agente.
- Orquestração: subagentes, divisão de tarefas, roteamento entre modelos.
- Memória: o que persiste entre sessões, como o
AGENTS.md.
Ou seja: o modelo carrega a inteligência, e o harness é o que torna essa inteligência útil.
As camadas do harness
Dá para enxergar o harness como camadas, imagem que vem do artigo da Birgitta Böckeler no site do Martin Fowler:
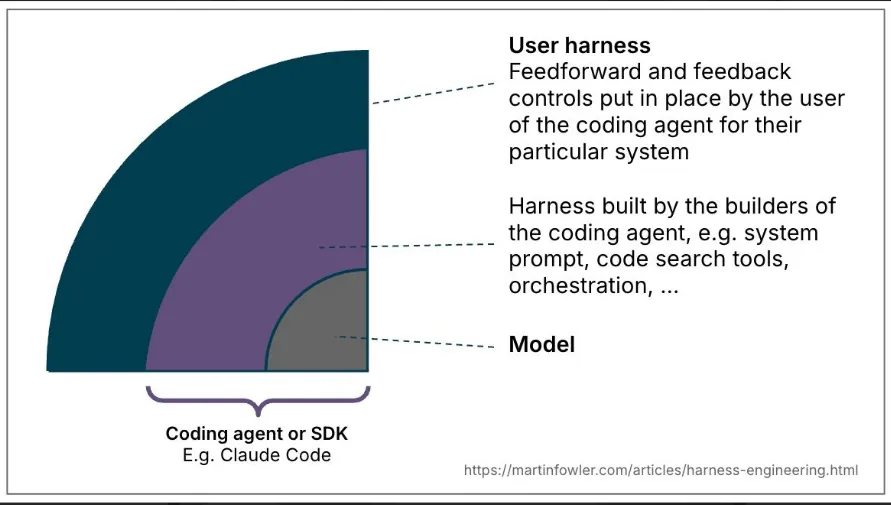
- Model: o centro de tudo. É a única parte que você não controla.
- Coding agent: o harness que o fabricante já entrega (system prompt, ferramentas de busca no código, orquestração). Ele é atualizado a cada versão nova do Cursor, do Claude Code, do Codex, e é proprietário. Você configura algumas coisas, mas não muda o núcleo.
- User Harness: os controles que você coloca no seu próprio sistema. AGENTS.md, rules, skills, hooks, testes, lint, CI.
O foco deste post é o User Harness, a camada de fora, porque é a única que conseguimos controlar.
Os três mecanismos: guias, sensores e grades de proteção
O user harness é feito de três tipos de mecanismos.
| Guias (Guides) | Sensores (Sensors) | Grades de proteção (Guardrails) | |
|---|---|---|---|
| Tipo | Feedforward | Feedback | Runtime |
| Quando age | Antes da execução | Depois da execução | Durante a execução |
| Exemplos | Prompt, AGENTS.md, rules, skills | Testes, linter, type checker, CI | Hooks, permissões, sandbox |
Em resumo:
Guias sugerem, Sensores detectam e Grades de Proteção previnem
Guias aumentam a chance de o agente acertar de primeira. Sensores avisam quando ele errou, e um sensor bom para LLM é aquele cuja mensagem de erro já diz como corrigir.
Já as grades de proteção existem por um motivo bem prático. Imagine que você não quer, de jeito nenhum, que o agente rode um rm -rf no projeto. Se você escreve isso no AGENTS.md, isso é um guia, e guia é não determinístico: o modelo lê, interpreta e pode simplesmente não seguir. Quem nunca pediu uma coisa para o agente e viu ele fazer outra?
Você não quer que em 90% das vezes o agente não apague o seu projeto. Você quer que em 100% das vezes o projeto continue lá. Para isso entra a grade de proteção, que é determinística. No Claude Code, por exemplo, um hook PreToolUse intercepta toda chamada de terminal antes de ela acontecer. Basta registrar um script como hook PreToolUse no .claude/settings.json:
#!/bin/bash
# .claude/hooks/block-rm-rf.sh
command=$(jq -r '.tool_input.command')

if [[ "$command" =~ rm[[:space:]]+-[a-zA-Z]*(rf|fr) ]]; then
  echo "rm -rf bloqueado pelo harness. Peça confirmação para a pessoa usuária." >&2
  exit 2 # exit 2 bloqueia a chamada e devolve a mensagem para o agente
fi
Repare que a mensagem de erro já diz ao agente o que fazer em seguida. A grade de proteção bloqueia e, de quebra, funciona como sensor.
Os hooks servem para muito mais do que bloquear comando perigoso. Eles disparam em eventos do agente (antes de chamar uma ferramenta, depois de editar um arquivo, ao iniciar uma sessão) e podem registrar o que aconteceu, adicionar contexto, permitir ou negar a ação. Um caso real de governança: negar a execução de qualquer MCP que não esteja na lista de MCPs aprovados pela empresa.
Rules x Hooks
Essa é uma dúvida comum, porque os dois parecem “regras”. A diferença está em quem decide:
- Rules podem ser sempre carregadas, carregadas sob demanda, aplicadas só em arquivos de um certo padrão ou deixadas para o agente decidir quando usar, com base na descrição do frontmatter (o bloco de metadados no topo do arquivo, entre linhas
---). Mas mesmo uma rule “sempre ativa” é lida pelo modelo, e é o modelo que decide se vai segui-la naquele caso. É inferencial. - Hooks são eventos. Se o evento acontece, o hook sempre dispara e o seu script sempre roda. É determinístico (a não ser que, dentro do hook, você chame outra LLM, mas aí já é outra história).
Como o harness roda?
Os mecanismos do harness podem ser executados de duas formas:
| Computacional | Inferencial | |
|---|---|---|
| Como | Determinístico e rápido | Análise semântica |
| Exemplos | Testes, lint, type checker | Code review de IA, uma LLM decidindo se uma mudança está boa |
| Custo | Milissegundos a segundos, praticamente de graça | Tokens e minutos a mais em cada execução |
A execução inferencial é poderosa. Com ela dá para ter uma LLM decidindo se uma alteração pode ir para produção, sem um humano no loop. Só que ela custa tokens e custa tempo: colocar um agente pensando em cada deploy pode adicionar minutos à pipeline.
Por isso a regra de ouro é: tudo o que puder ser computacional, deixe computacional. Teste unitário, lint e type checker são baratos, rápidos e confiáveis, e muito repositório ainda não tem os três configurados. Use o inferencial para o que só ele consegue avaliar, como se uma mudança faz sentido para o negócio.
O que é Engenharia de Harness?
Engenharia de Harness é o trabalho intencional e contínuo de projetar, ajustar e medir tudo o que cerca o modelo de linguagem (LLM), para que você possa confiar no que ele entrega.
Um AGENTS.md que ensina as convenções do projeto, um linter que roda depois de cada edição, um hook que bloqueia rm -rf sem confirmação. Tudo isso é engenharia de harness.
A palavra mais importante da definição é contínuo. O código é vivo e o harness regride. Alguém abre um PR, cria um monte de rules contraditórias, apaga o AGENTS.md ou deixa ele com mil linhas. Como saber que o harness piorou? Só medindo, e medindo de forma recorrente.
Nesse momento, você deve estar ainda com dúvidas do tipo…
- Como melhorar o harness de um repositório?
- Como aplicar no dia a dia?
- Como saber se tenho um bom harness?
- O que fazer para melhorar?
Harness Score: medindo a maturidade do repositório
O Harness Score é uma ferramenta open source, criada pelo Fernando Paladini, que mede a maturidade de harness de um repositório em segundos, aponta exatamente o que corrigir e acompanha o número subir.
Para rodar, não precisa instalar nem configurar nada. Basta estar na raiz do repositório:
npx harness-score
A sacada mais importante: a análise é determinística. Ela olha fatos do sistema de arquivos: se o AGENTS.md existe, se as rules têm frontmatter, se existe pipeline de CI, se há secrets expostos. Ou seja, é uma verificação computacional. Roda rápido, não gasta token e dá para colocar na pipeline com custo praticamente zero.
Por curiosidade, rodei no repositório deste blog:
harness-score v1.8.1  /home/renan/Documents/dev-root

Maturity: L0 · Unharnessed   Score: 26/105 (25%)   scopes: repo

Context & Guides     ██░░░░░░░░░░░░░░░░░░  10%  2/20 pts
Skills & Commands    ░░░░░░░░░░░░░░░░░░░░   0%  0/17 pts
Hooks & Guardrails   ░░░░░░░░░░░░░░░░░░░░   0%  0/14 pts
Sensors & Feedback   ████░░░░░░░░░░░░░░░░  20%  4/20 pts
CI Feedback          ░░░░░░░░░░░░░░░░░░░░   0%  0/14 pts
Hygiene & Safety     ████████████████████ 100%  20/20 pts

Improvements (25):
 ✗ CTX-01 Agent context file present (AGENTS.md) (+4 pts)
   Create an AGENTS.md at the repository root describing what the project is,
   how to build/test it, and the conventions agents must follow.
 ...
L0. Casa de ferreiro, espeto de pau. 😅
Cada item marcado com ✗ é um check que não passou, com a sugestão do que fazer e quantos pontos ele vale. O CTX-06, por exemplo, pede para quebrar rules com mais de 500 linhas em rules menores e com escopo.
Maturity Score x Effective Score
O harness não vive só no repositório. Por padrão, o npx harness-score olha só o repositório (Maturity Score). Com npx harness-score --scope user, ele também considera o que está na sua máquina, como skills globais e MCPs (Effective Score).
Os 5 níveis de maturidade
| Nível | Nome | O que significa |
|---|---|---|
| L0 | Sem harness | O repositório não dá nada ao agente: toda sessão parte do zero |
| L1 | Documentado | Existe AGENTS.md (ou equivalente) que garante o feedforward |
| L2 | Orientado | Já possui algum tipo de skill, subagent ou rules configuradas |
| L3 | Com sensores | O loop de feedback existe: linter, tipos, testes, pipeline de CI |
| L4 | Autocorretivo | Orienta, verifica, bloqueia e corrige continuamente |
Cada nível exige uma porcentagem mínima em algumas dimensões e acumula os requisitos dos anteriores, então não adianta ter CI perfeita sem AGENTS.md.
O score é uma bússola, não a verdade absoluta
Como a análise é determinística, ela não avalia semântica. Ela sabe que o seu AGENTS.md existe, mas não sabe se o que está escrito nele é bom. Uma rule desatualizada pontua igual a uma rule nova.
O tutorial oficial tem um exercício que mostra isso bem. Primeiro você cria um AGENTS.md propositalmente verboso. Depois resume o arquivo, mantendo só o essencial. O score não muda, mas o harness melhora: o AGENTS.md é carregado em toda conversa, e um arquivo de mil linhas ocupa a janela de contexto sem necessidade (lembra do post sobre Janela de Contexto?). O ideal é que ele funcione como um índice compacto, do tipo “se for fazer code review, leia tal arquivo; se for mexer no banco, leia aquele outro”.
Então leia o score assim: ele mostra quais ferramentas do mundo de IA você ainda não está usando e por que elas valem a pena. Um L1 não quer dizer que o harness é ruim, quer dizer que tem potencial sobrando.
E para o harness não regredir, dá para colocar a ferramenta como gate no CI, falhando a pipeline abaixo de um nível mínimo:
# .github/workflows/harness.yml
- uses: paladini/harness-score@v1
  with:
    min-level: '3'
Na prática: do L0 ao L4
O repositório paladini/harness-score-tutorial é um template para fazer esse caminho na sua máquina, com o agente que você preferir. O app de exemplo é o Meeting Cost CLI, uma aplicação pequena em Node.js que calcula o custo de uma reunião a partir do número de participantes, da duração e do custo por hora. Ele é simples de propósito, para o foco ficar no harness.
Cada etapa tem um prompt pronto. Você executa, olha o que mudou, roda o npx harness-score e compara:
| Etapa | O que o prompt faz | Nível |
|---|---|---|
| 0 | Cria o app sem harness nenhum | L0 · Unharnessed |
| 1 | Cria um AGENTS.md (verboso, de propósito) | L1 · Documented |
| 1B | Resume o AGENTS.md sem buscar pontos | L1 |
| 2 | Adiciona rule com escopo, skill, workflow, .gitignore e lockfile | L2 · Guided |
| 3 | Adiciona lint, formatter, type check, testes e CI | L3 · Sensing |
| 4 | Adiciona hooks: um que bloqueia comando destrutivo e outro que formata após editar | L4 · Self-correcting |
| 5 | Adiciona o gate de harness no CI para impedir regressão | L4 |
Como o agente é não determinístico, cada pessoa vai ter resultados um pouco diferentes. O que importa é ver o nível subindo a cada etapa e entender por que cada artefato existe.
Conclusão
O modelo (LLM) é a parte que você não controla, e vai continuar mudando com o tempo. O harness é a parte que está na sua mão e que faz o mesmo modelo entregar resultados muito diferentes de um repositório para outro.
Guias para o agente acertar de primeira, sensores para ele perceber quando errou e grades de proteção para que certas coisas nunca aconteçam. E, como todo código vivo, o harness precisa ser medido e cuidado continuamente.
Uma sugestão prática: rode npx harness-score no repositório em que você mais trabalha hoje. Leia os ✗, escolha um e resolva. Depois rode de novo. Eu já sei qual vai ser o próximo post deste blog: tirar ele do L0. 😅